IA local exige um orçamento de memória que inclua mais que o arquivo baixado. Pesos do modelo, cache de atenção, estruturas temporárias e o próprio programa disputam RAM ou VRAM. Um modelo que cabe no armazenamento pode falhar ao carregar, ao receber um texto longo ou ao atender mais de uma conversa.
Para começar, separe três perguntas: quantos bytes representam os pesos, quanto estado cresce durante a geração e em qual memória cada parte fica. Depois confira a implementação concreta. A estimativa ajuda a escolher um teste; não garante que uma configuração rode com determinada velocidade.
Neste artigo
A primeira conta: parâmetros vezes bits
Para um modelo hipotético com exatamente oito bilhões de parâmetros, uma conta idealizada dos pesos é:
bytes dos pesos = parâmetros × bits por parâmetro ÷ 8
| Representação hipotética de todos os pesos | Bytes calculados | Aproximadamente em GiB |
|---|---|---|
| 16 bits | 16.000.000.000 | 14,90 |
| 8 bits | 8.000.000.000 | 7,45 |
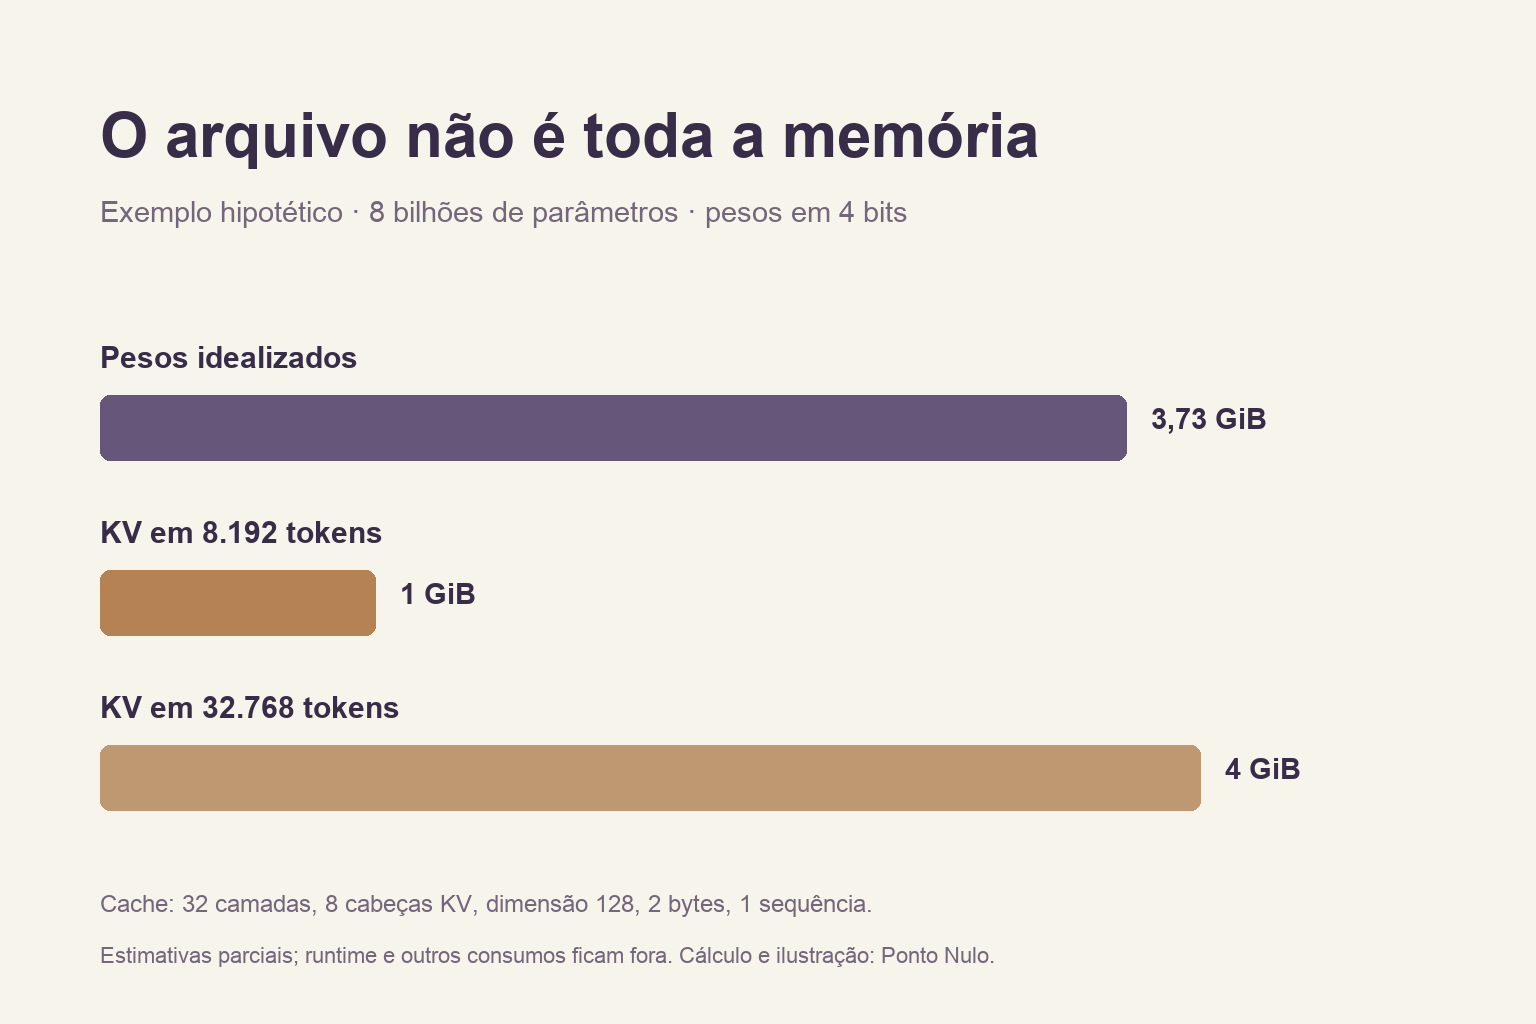
| 4 bits | 4.000.000.000 | 3,73 |
Dividimos os bytes por 2**30 para obter GiB. São contas de armazenamento dos valores, não medições de um arquivo ou de uma placa. Um nome comercial como “8B” também pode arredondar a quantidade real de parâmetros.
A documentação de quantização do Transformers explica a redução de precisão e as diferenças entre métodos. Na prática, escalas, metadados, alinhamento e partes mantidas em outra precisão acrescentam memória. “4 bits” não significa que todo o processo ocupará exatamente quatro bits por parâmetro.
O cache aumenta enquanto o contexto cresce
Em muitos modelos autorregressivos, o cache KV conserva chaves e valores de atenção para reutilização durante a geração. A explicação de caching da Hugging Face descreve esse estado e suas dimensões.
Para uma arquitetura hipotética com atenção global e cache de tamanho uniforme, podemos estimar:
bytes KV = 2 × camadas × cabeças KV × dimensão por cabeça
           × tokens armazenados × bytes por valor × sequências
O fator dois representa chaves e valores. O número de cabeças KV deve vir da arquitetura; não precisa ser igual ao número de cabeças de consulta. Trocar um pelo outro pode superestimar bastante uma arquitetura com atenção agrupada.
Considere 32 camadas, oito cabeças KV, dimensão de 128, dois bytes por valor e uma sequência:
| Tokens efetivamente armazenados | Cache KV calculado |
|---|---|
| 4.096 | 0,5 GiB |
| 8.192 | 1 GiB |
| 32.768 | 4 GiB |
Com duas sequências completas independentes do mesmo tamanho, essa parcela dobra no modelo simplificado. Prefixos compartilhados, paginação e outras otimizações podem mudar a alocação real. A tabela não simula essas implementações.
Uma conta reproduzível, sem baixar um modelo
Este código usa apenas aritmética do Python:
parametros = 8_000_000_000
pesos = parametros * 4 // 8
kv = 2 * 32 * 8 * 128 * 8192 * 2 * 1

print(round(pesos / 2**30, 2))
print(round(kv / 2**30, 2))
print(round((pesos + kv) / 2**30, 2))
O resultado é 3.73, 1.0 e 4.73. A última linha soma somente os pesos idealizados em quatro bits e esse cache KV. Não é uma recomendação de comprar uma GPU de capacidade próxima, porque a conta ainda deixa componentes de fora.
Nesse exemplo, reduzir os pesos de 16 para quatro bits não quantizou o cache: mantivemos dois bytes por valor KV. A precisão de cada componente precisa ser conferida separadamente.
Contexto anunciado não é memória constantemente ocupada
Uma janela máxima de contexto informa um limite suportado, não prova que toda execução mantenha exatamente essa quantidade de tokens. Entrada e saída gerada participam do crescimento do histórico, e uma ferramenta pode reservar mais espaço do que o necessário naquele momento.
O guia de estratégias de cache do Transformers distingue cache dinâmico, estático, quantizado e descarregamento para CPU. Alguns modelos também usam janelas deslizantes ou camadas com limites próprios. A fórmula anterior não deve ser aplicada a qualquer arquitetura sem conferir essas condições.
Um cache estático pode reservar capacidade antecipadamente. Um dinâmico pode crescer até que uma solicitação mais longa exponha falta de memória. Testar apenas uma pergunta curta não verifica o cenário de uso pretendido.
RAM e VRAM não formam automaticamente um único reservatório
Numa GPU dedicada, RAM do computador e VRAM da placa são espaços distintos. Offload pode distribuir partes do trabalho, mas depende do runtime e acrescenta transferências. Mais RAM não transforma, por conta própria, uma placa de oito GiB numa placa de 24 GiB.
Em sistemas com memória unificada, CPU e GPU compartilham recursos, mas o sistema operacional e outros aplicativos também os utilizam. A capacidade anunciada da máquina não é toda livre para o modelo. Antes de comparar equipamentos, registre onde ficam pesos, cache e processamento temporário.
Como conferir a estimativa numa execução real
Monte uma ficha com modelo e revisão, formato e quantização, runtime e versão, dispositivo, contexto, limite de saída e número de solicitações simultâneas. Observe a memória antes de carregar, depois da carga, durante o processamento da entrada e ao longo da geração.
Use um conjunto de entradas compatível com o uso esperado, incluindo a maior solicitação que você pretende aceitar. Registre também velocidade, falhas e uso de swap. Uma execução que evita erro recorrendo intensamente a outra memória pode continuar inadequada para a aplicação.
Se o consumo crescer além do previsto, investigue primeiro qual parcela aumentou. Diminuir contexto ou concorrência atua sobre um problema diferente de trocar a quantização dos pesos. Repita a comparação alterando uma condição por vez e mantenha a configuração que produziu cada resultado junto das medições.
