Texto de PDF selecionável não garante uma extração na ordem em que uma pessoa lê a página. Um arquivo pode guardar os objetos de uma coluna depois dos objetos da outra, misturar cabeçalhos com parágrafos ou posicionar cada palavra separadamente. Aplicar OCR sem identificar o problema pode acrescentar erros de reconhecimento a um texto que já existia.
O diagnóstico começa por duas perguntas: há texto digital aproveitável e a sequência extraída preserva o significado? A primeira orienta a necessidade de reconhecimento de imagem. A segunda exige conferir layout, blocos, colunas e vínculos entre os trechos.
Neste artigo
PDF digital, escaneado e híbrido
| Tipo de conteúdo | O que pode ser encontrado | Primeiro caminho a avaliar |
|---|---|---|
| Texto digital | Caracteres e posições definidos no arquivo | Extração direta, com conferência da ordem |
| Página escaneada | Imagem de uma folha ou tela | OCR, depois revisão do resultado |
| Imagem com camada de texto | Scan acompanhado de texto reconhecido anteriormente | Conferir a camada existente antes de reconhecer de novo |
| Documento misto | Páginas ou regiões com conteúdos diferentes | Escolher o método por página ou região |
A documentação do pypdf distingue essas situações e explica que o extrator não reconhece por conta própria o texto contido apenas em imagens. Mesmo nos arquivos digitais, a sequência dos objetos não equivale necessariamente a uma estrutura semântica de títulos, parágrafos e tabelas.
Selecionar uma frase no leitor é um sinal de que existe texto naquela região. Não demonstra que todas as páginas tenham texto, que o reconhecimento esteja correto ou que a ordem resultante sirva para uma automação.
Um arquivo pequeno que expõe o problema
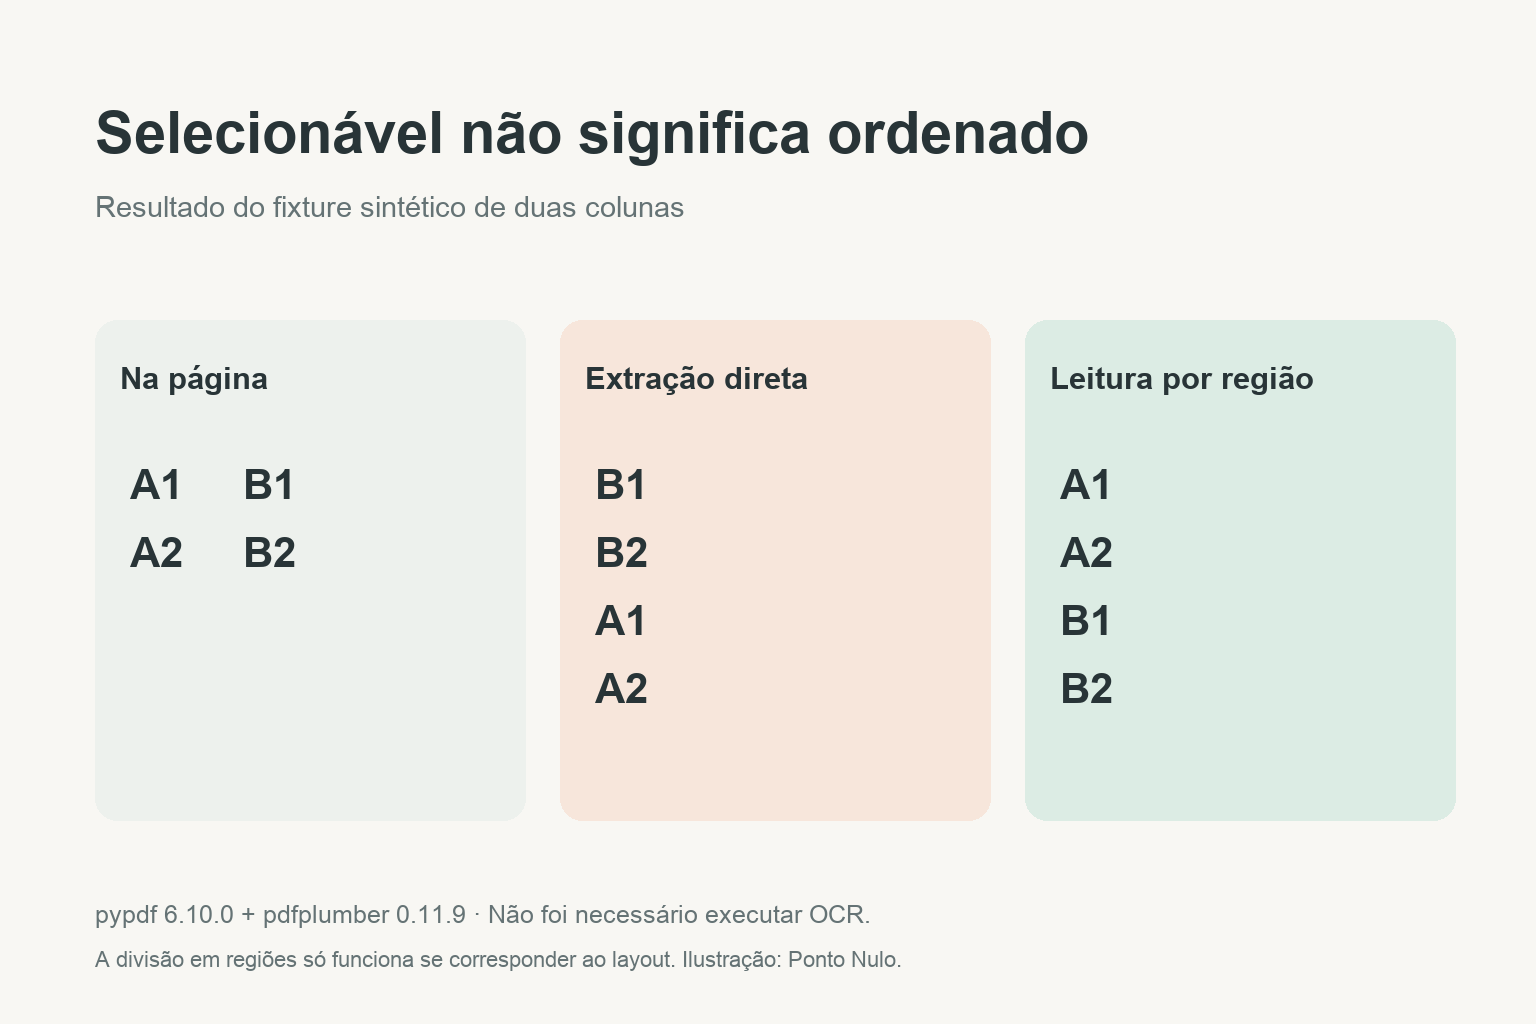
Para observar a diferença, criamos um PDF sintético de duas colunas. A leitura pretendida é terminar a coluna A e depois seguir para a B. Na geração do arquivo, porém, os textos de B foram inseridos antes dos textos de A.
O ensaio foi executado com pypdf 6.10.0 e pdfplumber 0.11.9, sem OCR. Os identificadores extraídos foram:
| Caminho | Sequência observada |
|---|---|
| Extração direta com pypdf | B1, B2, A1, A2 |
| Extração em modo layout com pypdf | A1, B1, A2, B2 |
| Extração por regiões com pdfplumber | A1, A2, B1, B2 |
O modo layout aproximou a disposição horizontal da página, mas não entregou a leitura por coluna pretendida. A escolha entre ler uma linha inteira e terminar uma coluna depende da estrutura do documento.
Esta é uma demonstração controlada desse arquivo. Não é uma comparação de qualidade geral entre bibliotecas. Em outros PDFs, o método que funciona pode mudar.
Como reproduzir a diferença
O trecho abaixo cria a mesma situação essencial: duas colunas visuais e objetos da coluna direita inseridos primeiro. Ele usa ReportLab para gerar o arquivo e pypdf para consultar a extração direta.
from reportlab.pdfgen import canvas
from reportlab.lib.pagesizes import A4
from pypdf import PdfReader

largura, altura = A4
c = canvas.Canvas("duas-colunas.pdf", pagesize=A4)
c.setFont("Helvetica", 13)
for x, y, texto in [
    (330, altura - 185, "B1 Terceiro passo"),
    (330, altura - 222, "B2 Quarto passo"),
    (44, altura - 185, "A1 Primeiro passo"),
    (44, altura - 222, "A2 Segundo passo"),
]:
    c.drawString(x, y, texto)
c.save()
print(PdfReader("duas-colunas.pdf").pages[0].extract_text())
Para esse layout conhecido, uma extração por regiões pode ler primeiro a esquerda e depois a direita:
import pdfplumber

with pdfplumber.open("duas-colunas.pdf") as documento:
    pagina = documento.pages[0]
    esquerda = pagina.crop((40, 150, 290, 250)).extract_text()
    direita = pagina.crop((325, 150, pagina.width - 35, 250)).extract_text()
    print(esquerda)
    print(direita)
Essas coordenadas foram escolhidas para o exemplo. Não devem ser aplicadas indiscriminadamente a uma pasta de documentos. A documentação do pdfplumber detalha recortes e informações de posição que permitem construir uma leitura adequada ao arquivo.
Quando o OCR é necessário
OCR reconhece caracteres a partir de uma imagem. Ele é útil quando a informação está no scan e não existe uma camada de texto aproveitável. Também pode fazer parte da recuperação de páginas cuja camada anterior esteja inutilizável, desde que o resultado seja comparado com o original.
Há, porém, problemas que permanecem depois do reconhecimento: uma tabela pode perder a associação entre coluna e valor; duas colunas podem ser intercaladas; um rodapé pode entrar no meio de uma frase. O guia de qualidade do Tesseract trata de resolução, inclinação, segmentação e dificuldades com tabelas. Reconhecer letras e reconstruir a estrutura são tarefas relacionadas, mas diferentes.
Um arquivo misto não precisa receber o mesmo tratamento em todas as páginas. É possível extrair diretamente as regiões digitais e reconhecer as regiões de imagem, mantendo uma referência de origem para a revisão.
O que conferir antes de entregar o texto a uma automação
A receita de extração de texto do PyMuPDF apresenta caminhos que preservam posições de palavras e blocos. Essas posições podem ajudar a recuperar uma ordem útil. Ainda assim, é necessário definir o que conta como uma unidade de informação no documento.
Monte uma amostra com os casos que podem mudar o resultado: números com separadores, datas, negações, tabelas, notas de rodapé e páginas com mais de uma coluna. Compare visualmente cada trecho com o texto entregue à próxima etapa. Contar caracteres extraídos não revela se o valor de uma despesa ficou associado à pessoa errada.
Se o conteúdo seguirá para um modelo de IA, preserve página e região de origem junto do trecho. Isso permite localizar uma resposta inesperada no documento. Uma saída bem formatada não corrige silenciosamente uma entrada embaralhada.
Para aceitar o processamento, registre quais páginas exigiram OCR, qual regra de ordenação foi usada e quais campos foram conferidos. Quando o layout variar além do que a regra consegue interpretar, encaminhe o documento para revisão em vez de reaproveitar coordenadas que deixaram de representar a página.
