EXPLAIN no PostgreSQL mostra o plano escolhido para executar uma consulta. Ele ajuda a localizar varreduras, filtros, junções e ordenações antes de decidir se um índice é necessário. A presença de uma leitura sequencial, sozinha, não demonstra um problema: percorrer a tabela pode ser a escolha adequada quando a consulta precisa de boa parte dos registros.
O primeiro passo é separar estimativa e execução. EXPLAIN apresenta o planejamento; EXPLAIN ANALYZE executa a instrução e acrescenta observações da execução. Essa diferença determina onde é seguro experimentar.
Neste artigo
Antes de medir, preserve o escopo da consulta
O manual do comando EXPLAIN alerta que ANALYZE realmente executa a instrução. Não o acrescente casualmente a um UPDATE, DELETE ou chamada com efeitos. Mesmo uma consulta de leitura pode consumir recursos ou chamar funções com efeitos próprios.
Para aprender a ler um plano, prefira um banco descartável com dados sintéticos. No ambiente real, registre a consulta, os parâmetros, o volume de dados e a versão do servidor. Um plano obtido para um cliente com poucas linhas pode não representar outro que concentra quase toda a tabela.
Um laboratório com 200 mil registros
Executamos o exemplo abaixo em PostgreSQL 16.15, num contêiner local isolado, sem conexão com banco de produção. A tabela distribui 200 mil pedidos igualmente entre mil identificadores de cliente:
CREATE TABLE pedidos_demo (
  id integer,
  cliente_id integer,
  detalhe text
);

INSERT INTO pedidos_demo
SELECT i, i % 1000, repeat('x', 120)
FROM generate_series(1, 200000) AS i;

ANALYZE pedidos_demo;

EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT id, detalhe
FROM pedidos_demo
WHERE cliente_id = 42;
O resultado correto dessa consulta contém 200 linhas. A distribuição foi construída para isso; não descreve uma carga de trabalho de uma empresa. A comparação abaixo considera essa distribuição e as configurações do ensaio.
Leia a árvore antes de comparar números
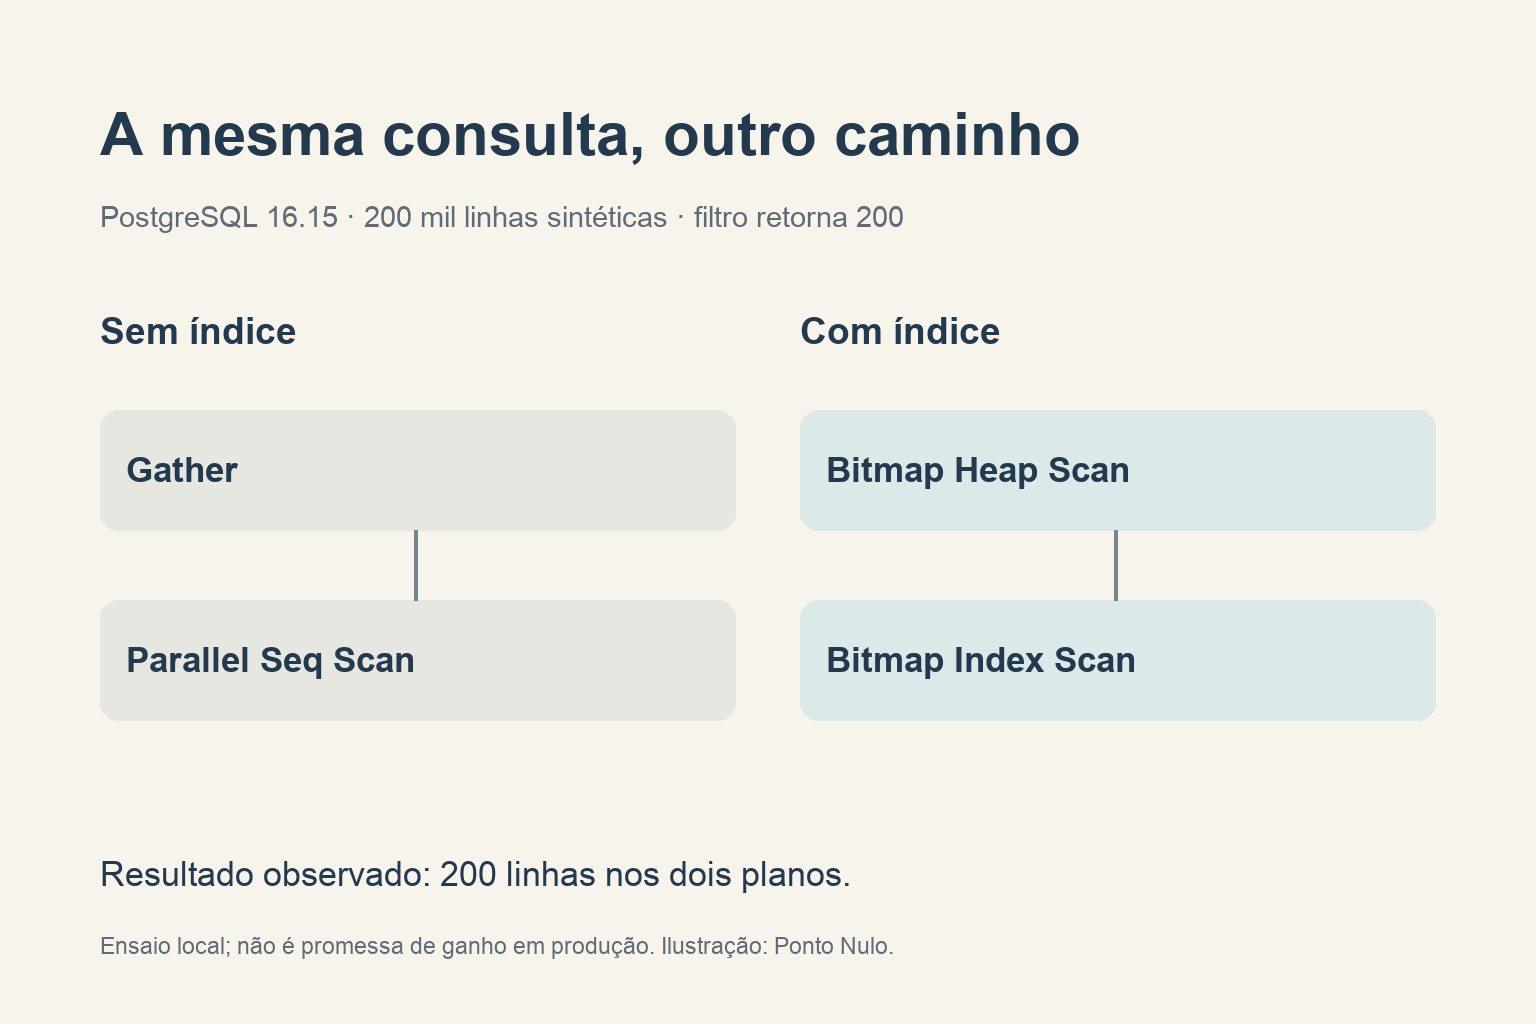
Sem índice em cliente_id, o plano observado usou Gather sobre uma varredura sequencial paralela. Depois da criação do índice, usou Bitmap Heap Scan alimentado por Bitmap Index Scan.
| Observação do ensaio | Antes do índice | Depois do índice |
|---|---|---|
| Nó no topo | Gather |
Bitmap Heap Scan |
| Linhas estimadas no topo | 198 | 199 |
| Linhas efetivamente entregues | 200 | 200 |
| Caminho de acesso | Varredura sequencial paralela | Índice para localizar posições e leitura da tabela |
O segundo plano foi obtido após executar:
CREATE INDEX pedidos_demo_cliente_idx
ON pedidos_demo (cliente_id);

ANALYZE pedidos_demo;

EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT id, detalhe
FROM pedidos_demo
WHERE cliente_id = 42;
Não desabilitamos a leitura sequencial para obrigar o uso do índice. O planejador mudou o caminho após a nova estrutura e a atualização de estatísticas. Outro servidor pode escolher uma árvore ou estimativas diferentes.
Custo não é tempo em milissegundos
A documentação de leitura de planos distingue custo estimado, quantidade de linhas e observações de execução. O custo usa unidades do modelo do planejador; não deve ser lido como duração de relógio.
Também é necessário respeitar a árvore. O custo de um nó superior incorpora seus descendentes. Somar todos os custos como se fossem etapas independentes conta trabalho mais de uma vez.
Compare a estimativa de linhas com o resultado efetivo no mesmo nó. Uma grande diferença pode justificar investigar estatísticas, distribuição dos valores ou condições da consulta. Não prova automaticamente que falta um índice.
No ensaio, o nó paralelo inferior apresentou médias por execução e três loops. Multiplicar valores arredondados não precisa reproduzir exatamente as 200 linhas do topo. Observe loops antes de tratar uma quantidade intermediária como o total da consulta.
O que os buffers acrescentam
No topo do plano inicial apareceram 4.082 blocos compartilhados encontrados em cache e nenhum lido pelo PostgreSQL. No segundo, foram 200 encontrados e dois lidos. Esses valores descrevem este ensaio, com os dados e o estado de cache existentes naquele momento.
Um bloco registrado como lido pelo PostgreSQL não comprova uma operação física no SSD: o sistema operacional também pode ter cache. Tampouco é correto somar indiscriminadamente contagens de nós superiores e inferiores.
Por essa razão, não usamos a execução curta para anunciar que o índice deixa qualquer consulta uma quantidade fixa de vezes mais rápida. O exemplo demonstra uma mudança de acesso para um filtro seletivo. Cache, concorrência, distribuição e custo de manter o índice precisam de avaliação própria.
Quando um índice não é a próxima alteração
Considere uma busca que retorna quase todos os pedidos. Mesmo com índice disponível, localizar cada linha por ele pode não ser vantajoso. Se o problema estiver numa ordenação grande, numa junção que multiplica linhas ou no envio de um resultado excessivo ao cliente, criar um índice qualquer não responde à causa observada.
Antes de alterar o esquema, anote o nó que concentra trabalho, a diferença entre linhas estimadas e observadas, os loops e o comportamento de buffers. Verifique ainda se a consulta está pedindo os dados necessários e se seus parâmetros representam o caso lento.
Depois de uma mudança justificada, repita a mesma consulta em condições comparáveis e confira tanto o plano quanto o resultado. Preserve os dois registros junto da versão e do conjunto de dados. Para levar um índice ao ambiente real, inclua também o custo de armazenamento, das escritas e da própria operação de criação no planejamento.
