Teste A/B com pouco tráfego pode terminar sem evidência suficiente para escolher uma versão. Ver uma taxa de 6% contra outra de 4% não basta: é necessário conhecer quantas pessoas participaram, como foram distribuídas e qual incerteza acompanha a diferença.
Um teste inconclusivo também não demonstra que as versões são equivalentes. Pode existir um ganho relevante que a amostra ainda não consegue distinguir da variação aleatória. A decisão depende do efeito que vale a pena detectar e de quanto tempo e tráfego o produto consegue dedicar ao experimento.
Neste artigo
O que significa “50% melhor” em uma amostra pequena
Considere um exemplo hipotético de cadastro concluído. Cada pessoa participa uma vez, é atribuída aleatoriamente a um grupo e tem seu resultado medido da mesma maneira.
| Grupo | Pessoas | Cadastros concluídos | Conversão |
|---|---|---|---|
| A | 200 | 8 | 4% |
| B | 200 | 12 | 6% |
A diferença observada é de 2 pontos percentuais. O ganho relativo é de 50%, porque 6 dividido por 4 resulta em 1,5. As duas descrições estão corretas, mas destacam aspectos diferentes. Sem os denominadores, o número relativo esconde que a diferença veio de quatro conversões.
Se a métrica fosse outra — cliques, receita, retenção — a análise também mudaria. Antes do teste, escolha uma métrica ligada ao comportamento que importa para o produto, e defina sua janela de observação. Um clique que antecede o abandono não responde à mesma pergunta que um cadastro concluído.
Um intervalo que ainda admite perda e ganho
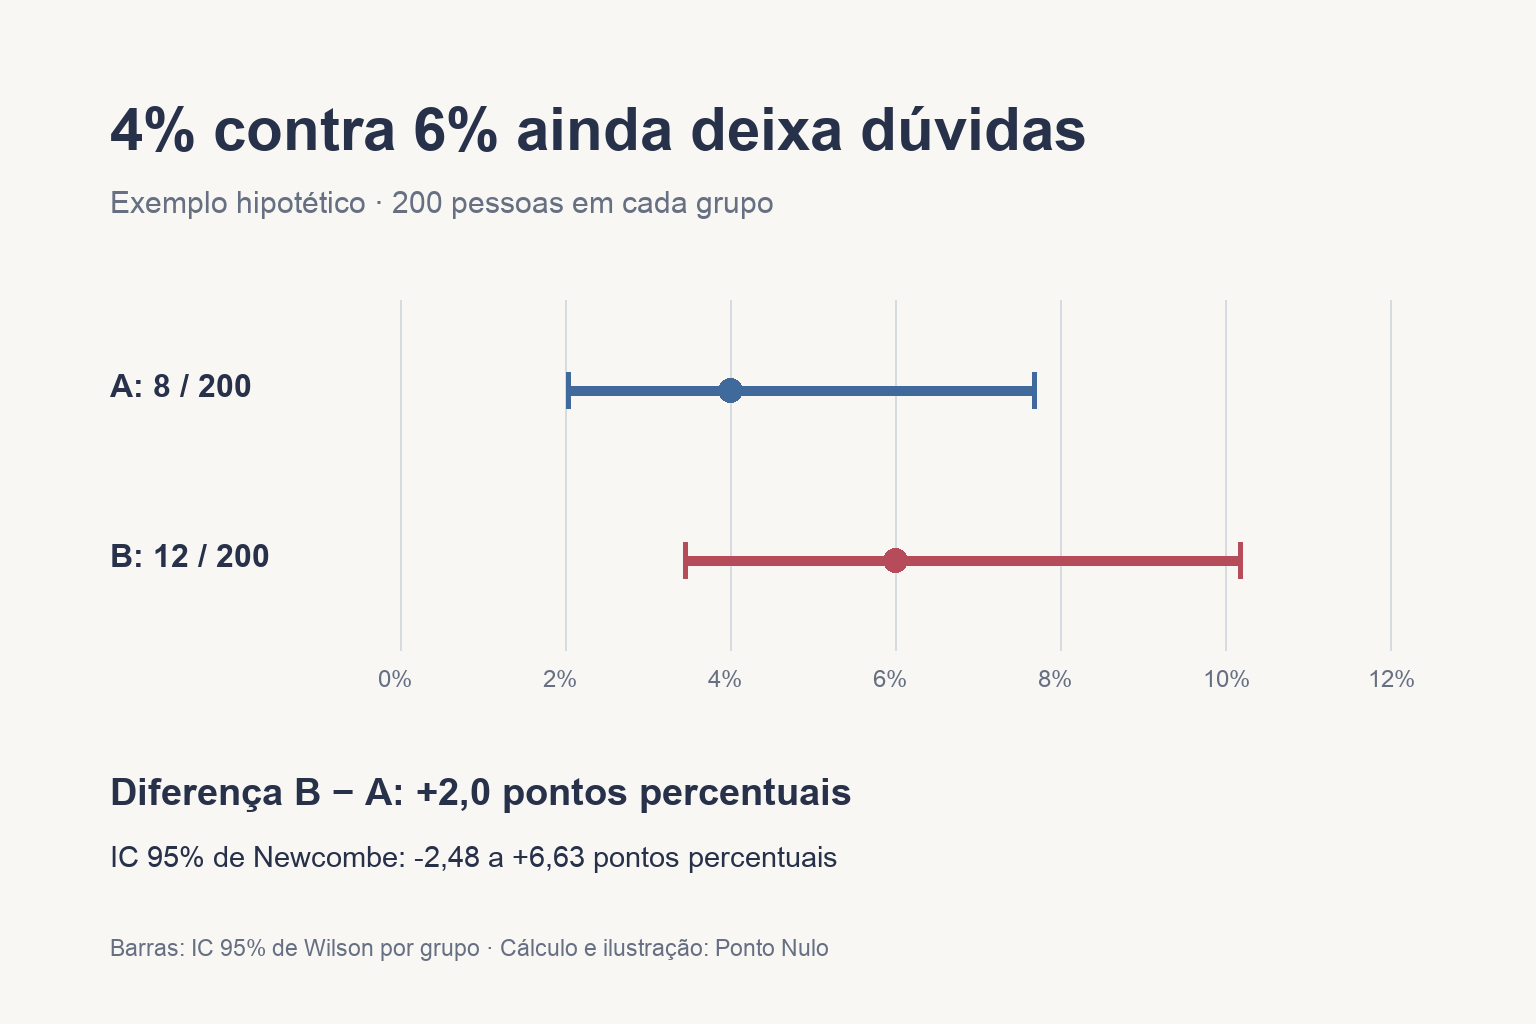
Calculamos intervalos de 95% de Wilson para as proporções do exemplo. O grupo A fica aproximadamente entre 2,04% e 7,69%; o B, entre 3,47% e 10,19%.
Para comparar os grupos, calculamos também o intervalo de Newcombe para a diferença B menos A, método disponível na documentação estatística do statsmodels. O resultado foi de aproximadamente −2,48 a +6,63 pontos percentuais.
Esse intervalo inclui zero e comporta tanto uma perda quanto um ganho. Nas condições assumidas pelo cálculo, a amostra não sustenta declarar B superior. A conclusão não vem apenas de observar a sobreposição das barras de cada grupo: o intervalo da diferença foi calculado separadamente.
Os dados são fictícios e os cálculos descrevem um modelo de duas proporções independentes. Eles não são resultados medidos no Ponto Nulo. Se a mesma pessoa aparecer repetidamente, houver dependência entre usuários ou o resultado for medido em momentos diferentes, é preciso adequar o método.
A amostra começa pelo efeito que interessa
“Quantas visitas preciso?” não tem uma resposta única. Depende da taxa de partida, do menor efeito que mudaria a decisão, da probabilidade de detectar esse efeito e do limite de falso positivo adotado.
O trabalho de Jing Zhou, Jiannan Lu e Anas Shallah, All about sample-size calculations for A/B testing, discute o dimensionamento e a diferença entre efeitos absolutos e relativos. A pergunta de planejamento deve ser formulada antes da coleta, usando hipóteses justificadas.
Para ilustrar, suponha um teste futuro com taxa histórica de 4%, taxa-alvo de 6% — ganho mínimo de interesse de 2 pontos percentuais —, alocação igual, teste bilateral com nível de 5% e poder de 80%. Uma aproximação normal de planejamento resulta em 1.863 pessoas por grupo, ou 3.726 no total.
Com 50 novas pessoas elegíveis por dia, seriam cerca de 75 dias só para alcançar esse total. Essa conta não determina que o teste deva durar 75 dias: ela mostra que o efeito desejado pode não combinar com o tráfego disponível. Nesse período, mudanças de campanha, sazonalidade ou do próprio produto também precisam ser consideradas.
O planejamento é anterior ao experimento. Não se deve usar o resultado parcial para escolher repetidamente uma nova meta de amostra até aparecer significância.
O teste precisa estar correto antes de estar grande
Uma amostra maior não corrige uma comparação mal construída. Confira se a atribuição é aleatória, se cada pessoa permanece no grupo correto e se a contagem inclui a população elegível prevista.
Registre o momento em que a pessoa entra no experimento e o prazo para observar a conversão. Se o grupo B ganhou usuários ontem e o A já acumula uma semana de acompanhamento, a comparação de taxas pode estar misturando tempos de exposição diferentes.
Também verifique se a intervenção altera o caminho de medição. Um botão novo que dispara dois eventos pode elevar a contagem sem melhorar o resultado. Use contagens por unidade experimental e acompanhe sinais de erro, abandono ou prejuízo à experiência.
Olhar o painel todo dia não deve mudar a regra de parada
É razoável acompanhar problemas operacionais durante um teste. Isso é diferente de interromper um desenho de amostra fixa assim que um resultado favorável aparece. Escolher o momento de encerramento depois de observar os dados altera as condições da análise.
Defina previamente população, métrica principal, efeito relevante, método e regra de parada. Se o produto precisa tomar decisões continuamente, procure um desenho estatístico que contemple esse acompanhamento desde o início. Não aplique automaticamente o intervalo de um teste de horizonte fixo a uma regra de parada improvisada.
O que fazer quando o tráfego não comporta a pergunta
Há alternativas que ajudam a decidir sem fabricar uma conclusão estatística. Um teste de usabilidade pode revelar que as pessoas não entendem um campo; uma análise do funil pode localizar um erro técnico; uma mudança claramente corretiva pode ser validada por requisitos e regressões. Esses métodos respondem a perguntas próprias, sem estimar o mesmo efeito causal de um experimento aleatório.
Antes de continuar coletando, compare o custo da incerteza com o da decisão. Se o experimento permanecer inconclusivo, registre a diferença observada, seu intervalo, a amostra e as limitações. Se surgir outra versão para testar, abra um novo experimento com hipótese e regra de parada próprias.
