A Cloudflare colocou o Cloudflare AI Search em disponibilidade geral nesta quinta-feira, 1 de outubro de 2026. O serviço transforma sites, buckets R2 e arquivos enviados diretamente em índices para busca por linguagem natural. A versão liberada para uso geral acrescenta recuperação multimodal por imagens, reconhecimento óptico de caracteres em PDFs digitalizados e suporte a arquivos maiores. A Cloudflare informou que a cobrança começa em 1 de novembro, com uma franquia mensal incluída em todas as contas.
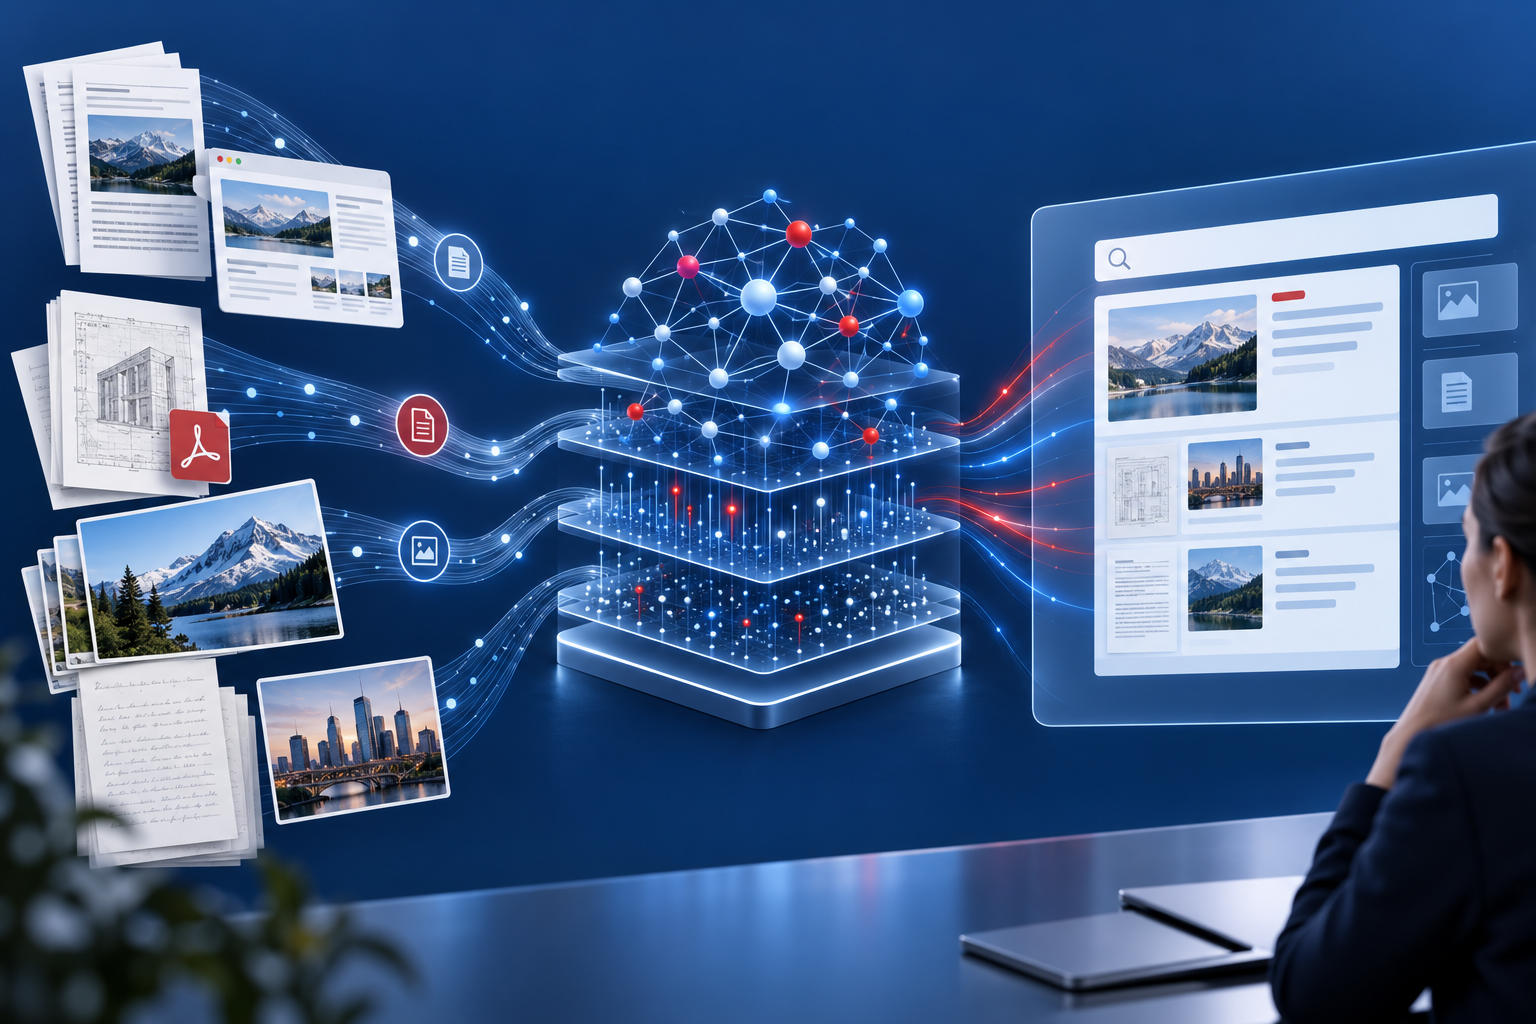
O produto reúne etapas que normalmente seriam contratadas ou implementadas separadamente: leitura das fontes, conversão para Markdown, divisão do conteúdo em trechos, criação de embeddings, índice por palavras-chave, busca vetorial, combinação de resultados e reranking. A geração de uma resposta por modelo de linguagem é opcional. Com isso, equipes podem usar apenas os trechos recuperados ou entregar uma resposta sintetizada sobre o próprio acervo.
O que muda com a disponibilidade geral
O Cloudflare AI Search já estava disponível antes do anúncio, mas ainda em fase de evolução e sem o modelo definitivo de cobrança. A passagem para disponibilidade geral estabelece os recursos de produção, os limites por plano e os valores que entram em vigor em novembro.
O serviço funciona sobre componentes da própria plataforma. Workers AI participa da conversão e da execução de modelos; Vectorize armazena e consulta vetores; R2 mantém o conteúdo; e Browser Run pode percorrer páginas de um site conectado. Essa composição fica escondida atrás de uma instância gerenciada do AI Search, sem exigir que o desenvolvedor monte cada integração por conta própria. O lançamento amplia a plataforma que, em setembro, também levou os Python Workers à disponibilidade geral.
Segundo a documentação técnica, uma instância pode receber arquivos diretamente, conectar um bucket R2 ou indexar um domínio. A sincronização de fontes conectadas é automática. Nos envios diretos, cada novo arquivo entra na fila de indexação assim que chega ao armazenamento interno.
Como o conteúdo vira um índice pesquisável
A indexação começa pela leitura da fonte. Formatos estruturados ou ricos são convertidos para Markdown antes do processamento. O texto resultante é dividido em trechos menores, chamados de chunks, para que cada resultado represente uma parte específica do documento em vez de apenas o arquivo inteiro.
Cada trecho recebe um embedding, uma representação numérica usada para comparar significados. Se a pesquisa por palavras-chave estiver ativa, o mesmo trecho também entra em um índice invertido com correspondência BM25. A instância passa, assim, a aceitar busca vetorial, busca textual ou uma combinação das duas.
Essa combinação é relevante em acervos técnicos. A busca vetorial pode encontrar passagens semanticamente próximas mesmo quando a pergunta não repete os mesmos termos do documento. A busca por palavras-chave preserva a precisão de códigos de erro, nomes de produtos, comandos e identificadores que não devem ser aproximados. No modo híbrido, o AI Search executa os dois caminhos e funde os resultados.
O caminho de uma consulta
Quando uma aplicação envia uma pergunta, o serviço pode primeiro reescrevê-la com um modelo para melhorar a recuperação. Essa etapa é opcional. A consulta original ou reescrita é convertida em embedding e comparada com os vetores armazenados. No modo híbrido, uma busca BM25 acontece em paralelo.
Os resultados vetoriais e textuais podem ser combinados e passar por reranking. Nesse estágio, outro modelo avalia a consulta e cada trecho em conjunto para reorganizar os candidatos. O endpoint de busca devolve os trechos encontrados; o endpoint compatível com Chat Completions pode encaminhá-los a um modelo de geração e devolver uma resposta pronta.
O desenho permite separar recuperação de geração. Uma equipe pode usar o Cloudflare AI Search apenas para encontrar documentos e manter a elaboração da resposta em outro componente. Também pode conectar um provedor externo pelo AI Gateway. Chamadas externas, reescrita de consultas e geração continuam sujeitas ao registro e à cobrança do serviço usado, enquanto embeddings e reranking executados pelo próprio AI Search entram no preço da plataforma.
Imagens e PDFs entram na busca
A principal ampliação anunciada no GA é a recuperação multimodal. Modelos compatíveis podem transformar os pixels de uma imagem diretamente em embeddings, colocando texto e imagem no mesmo espaço de comparação. Isso permite consultar coleções por aparência, composição ou semelhança visual sem depender apenas de uma legenda produzida previamente.
O catálogo de modelos suportados lista o Qwen3-VL-Embedding 2B como opção de embeddings com suporte a imagens. Quando a instância usa um modelo somente textual, o serviço converte a imagem em uma descrição antes de indexá-la. Nesse caso, a pesquisa depende das características capturadas pela legenda e pode perder detalhes visuais que não foram descritos.
O OCR cobre outro tipo de acervo: PDFs escaneados e imagens com texto. A documentação das fontes de dados informa que o recurso precisa ser habilitado na configuração da instância e que sua ativação provoca uma reindexação completa. PDFs com OCR podem ter até 10 MiB. Sem OCR, o limite permanece em 4 MiB. Arquivos de texto, código e configuração também aceitam até 10 MiB.
Planilhas, documentos do Word, arquivos OpenDocument, HTML, CSV e formatos de imagem aparecem na lista de formatos convertidos para Markdown. O suporte ao tipo do arquivo não garante que toda estrutura seja preservada: tabelas complexas, diagramas e layouts visuais ainda dependem da conversão e do modelo escolhido.
Preços começam em novembro
A cobrança do Cloudflare AI Search começa em 1 de novembro de 2026. Cada conta recebe mensalmente 5 milhões de tokens de ingestão, 10 GB-mês de armazenamento, mil consultas semânticas e mil consultas de texto completo. A franquia vale tanto para o plano Workers Free quanto para o Workers Paid.
Depois desses limites, a tabela oficial de preços estabelece US$ 0,75 por milhão de tokens na ingestão, com adicional de US$ 0,50 por milhão para processamento de imagens. O armazenamento custa US$ 2 por GB-mês. Consultas semânticas, vetoriais ou híbridas custam US$ 0,75 por mil requisições, enquanto a busca textual custa US$ 0,10 por mil.
O custo de ingestão é calculado depois da conversão e da divisão em trechos. Quando há sobreposição entre chunks, o texto repetido é contado em cada trecho. Em imagens e documentos escaneados, o texto extraído também entra na medição de processamento visual. Por isso, duas bases com o mesmo tamanho em bytes podem produzir contas diferentes conforme formato, chunking, quantidade de imagens e frequência de reindexação.
Geração de respostas e provedores externos não fazem parte dessa tabela. Se a aplicação usar um modelo de texto para redigir a resposta final, essa inferência pode gerar cobrança adicional no Workers AI ou no provedor conectado. O mesmo vale para a reescrita da consulta quando ela estiver habilitada. A franquia do AI Search, portanto, não representa o custo completo de uma aplicação; geração, provedores externos e volume de atualização precisam entrar no controle de custos de IA.
AI Search e Vectorize atendem necessidades diferentes
O AI Search usa o Vectorize, mas os dois produtos não são equivalentes. No Vectorize, a aplicação gera os vetores, envia os dados e controla a lógica de recuperação. No AI Search, a Cloudflare administra conversão, chunking, embeddings, sincronização, busca híbrida, reranking e, opcionalmente, geração.
O serviço gerenciado reduz a quantidade de componentes para uma equipe que precisa pesquisar documentação, catálogos, bases internas ou páginas de suporte. O recorte é diferente do Bedrock AgentCore Web Search, voltado a pesquisar a web com fontes citadas: o AI Search cria um índice gerenciado sobre conteúdo enviado ou conectado pelo cliente. O Vectorize continua oferecendo mais controle para arquiteturas que já possuem pipeline de ingestão, modelos de embeddings definidos, regras próprias de segmentação ou requisitos que não cabem nos limites do AI Search.
Essa escolha também afeta portabilidade. Dados originais podem continuar em um site ou bucket, mas configuração de índices, metadados, chunking e comportamento de recuperação pertencem ao pipeline da plataforma. Uma eventual migração exige reconstruir essas etapas em outro ambiente e reavaliar a qualidade dos resultados.
O que ainda precisa ser medido em produção
O anúncio e a documentação descrevem recursos, limites e preços, mas não apresentam comparações independentes de relevância, latência ou custo total contra outros serviços de busca gerenciada. A qualidade depende do conteúdo de origem, da conversão, do tamanho dos trechos, do modelo de embeddings, do modo de busca e do reranking configurado.
Também há limites operacionais. No plano gratuito, o rastreamento de sites fica limitado a 500 páginas por dia. Cada instância aceita até 100 mil arquivos no Workers Free; no plano pago, o teto chega a 1 milhão de arquivos, ou 500 mil quando a busca híbrida está ativa. Filtros de metadados e pesquisas entre várias instâncias possuem limites próprios que precisam ser conferidos antes de desenhar um produto multi-tenant ou um acervo muito grande.
O Cloudflare AI Search já pode ser ativado e usado. A busca multimodal, o OCR e os novos limites estão disponíveis desde 1 de outubro; a cobrança por uso acima da franquia começa em 1 de novembro de 2026.
